v1.8 新增 dr 模块及其十一个新场景,并把 Kafka CLI 终端带进自由模式。
这个版本聚焦于 Kafka 中几种较难的架构:拉伸集群、多区域部署、故障切换、MirrorMaker 2 以及灾难恢复。它还新增了专题 13,其中的九个场景直接在终端里操作。合计 20 个新场景,课程体系达到 134 个中的 100 个。
v1.8 里有什么
集群拓扑本身并不新。自 v1.3 起,它们就陆续出现在自由模式里:先是主备和双活这两种镜像对,随后是 3-DC 和 2.5-DC 拉伸集群。
缺的是围绕它们的课程。v1.8 新增十一个场景,带你走一遍这些架构在出问题时如何表现、为什么会以不同的方式失败,以及这些失败在实践中意味着什么。
拉伸集群(六个场景)。 一个分布在多个站点上的 Kafka 集群,在这里失去一个 DC 是复制问题,而不是区域级的故障切换:
- 2-DC - 一次
acks=all写入同时存在于两个站点,因此无论失去哪个站点,它都依然持久。 - 3-DC 与 2.5-DC - 三票中两票的多数,或者一个见证站点,让控制器选举在一个 DC 故障后仍能照常进行。在 2.5-DC 部署中,幸存 DC 里的一个 observer 会被自动提升进 ISR,以恢复
min.insync.replicas。 - 没有见证站点的 2-DC - 把偶数个投票者一分为二会失去仲裁多数,因此 leader 选举会停止,直到连通性恢复。
- 失去 leader 所在的 DC,以及单个 DC 内部的分裂 - 领导权转移到幸存的站点;如果某个 DC 内部的一条链路故障,被隔离的副本会退出 ISR,直到该分区降到它的 min.ISR 下限。
镜像集群(五个场景)。 两个由 MirrorMaker 2 连接的独立 Kafka 集群,在这里失去一个区域意味着要故障切换到另一个集群:
- 镜像滞后与 RPO - 切断复制链路,让滞后累积起来,执行故障切换,然后准确看到哪些记录没能复制过去。
- 双活 - 每个区域拥有自己那个区域专属的主题,并把它镜像到另一侧。
- offset 转换 - 消费者转移到另一个集群之后,不能简单地沿用原来的 offset。MM2 的 checkpoint 会转换这些 offset,消费者则会重放自最近一次 checkpoint 以来的尾部记录。
- 回切(failback) - 让原来的主集群重新上线、重新同步,并在不丢失数据的前提下恢复正向复制。
Kafka CLI 终端模拟器
v1.8 的另一大部分,是一个从底部向上滑出的终端抽屉(Ctrl+`),它针对模拟集群运行 Kafka CLI 命令。
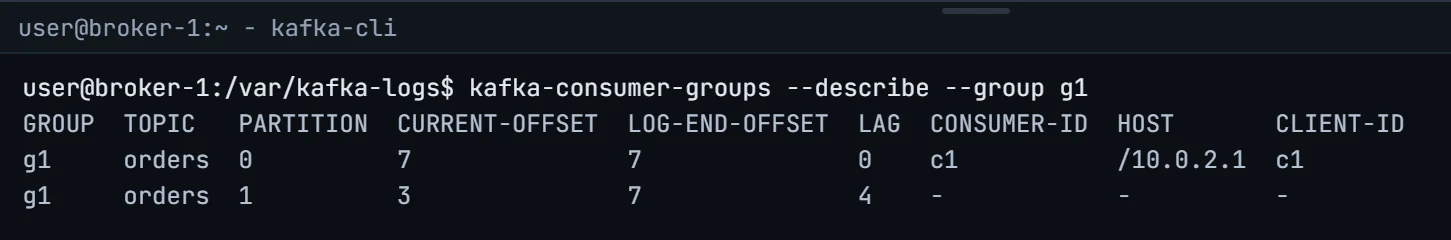
一共有十五个工具:kafka-topics、kafka-consumer-groups、kafka-configs、kafka-log-dirs、kafka-reassign-partitions、kafka-leader-election、kafka-get-offsets、kafka-metadata-quorum、kafka-replica-verification、kafka-server-stop、kafka-server-start、kafka-console-producer、kafka-console-consumer、kafka-transactions,外加用于查看你当前所连接拓扑的 cluster-info。
这些命令使用与真实 Kafka 工具相同的参数,以及同样熟悉的、按列对齐的输出。如果模拟器只实现了某个命令的一部分,该命令的 --help 会说明这一点。
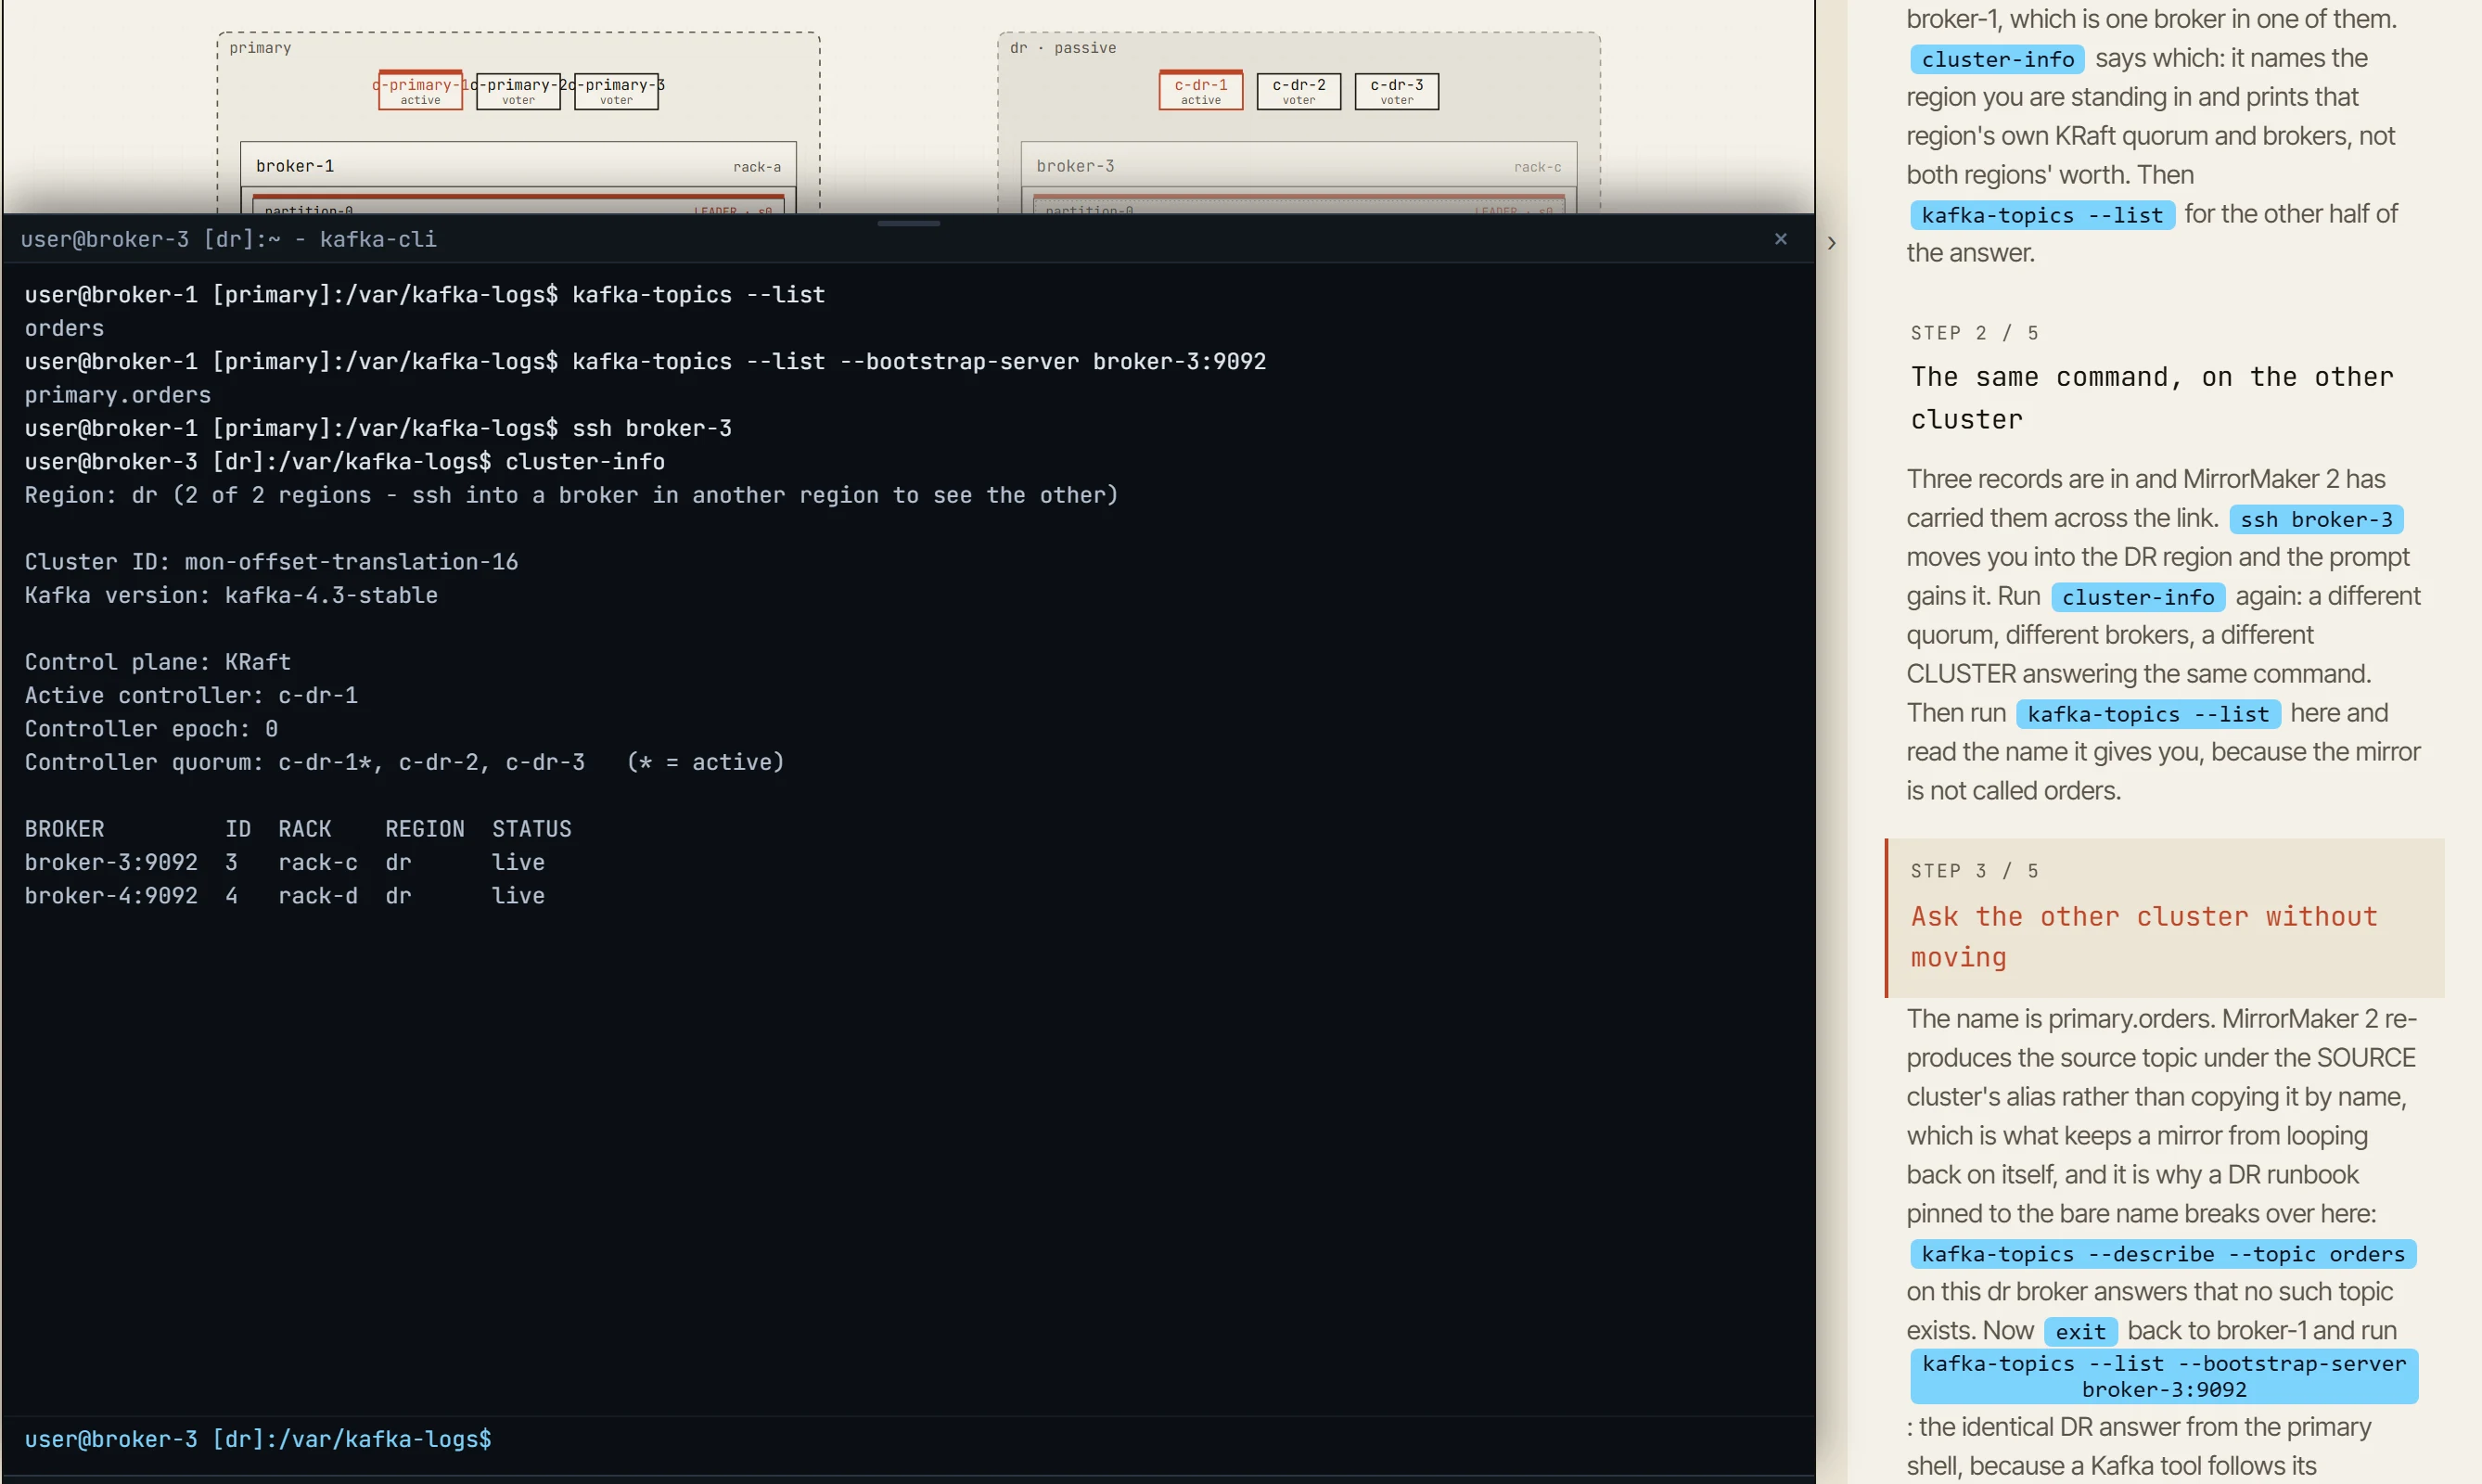
你登录在哪台主机上很重要。 提示符会显示当前主机,ssh 用于在主机之间切换,终端抽屉里也有一个主机菜单。你还可以在画布上按住 Alt 点击某个 broker。
命令作用于与该主机关联的集群。例如在多区域拓扑上,从一个 DR broker 运行 kafka-topics --list,显示的是 MirrorMaker 2 的远端主题,而不是源主题。cluster-info 显示的是该区域的仲裁组,而不是两个集群合并后的视图。
你也可以把 --bootstrap-server 指向另一个区域的 broker,在不离开当前 shell 的情况下查询那个集群。
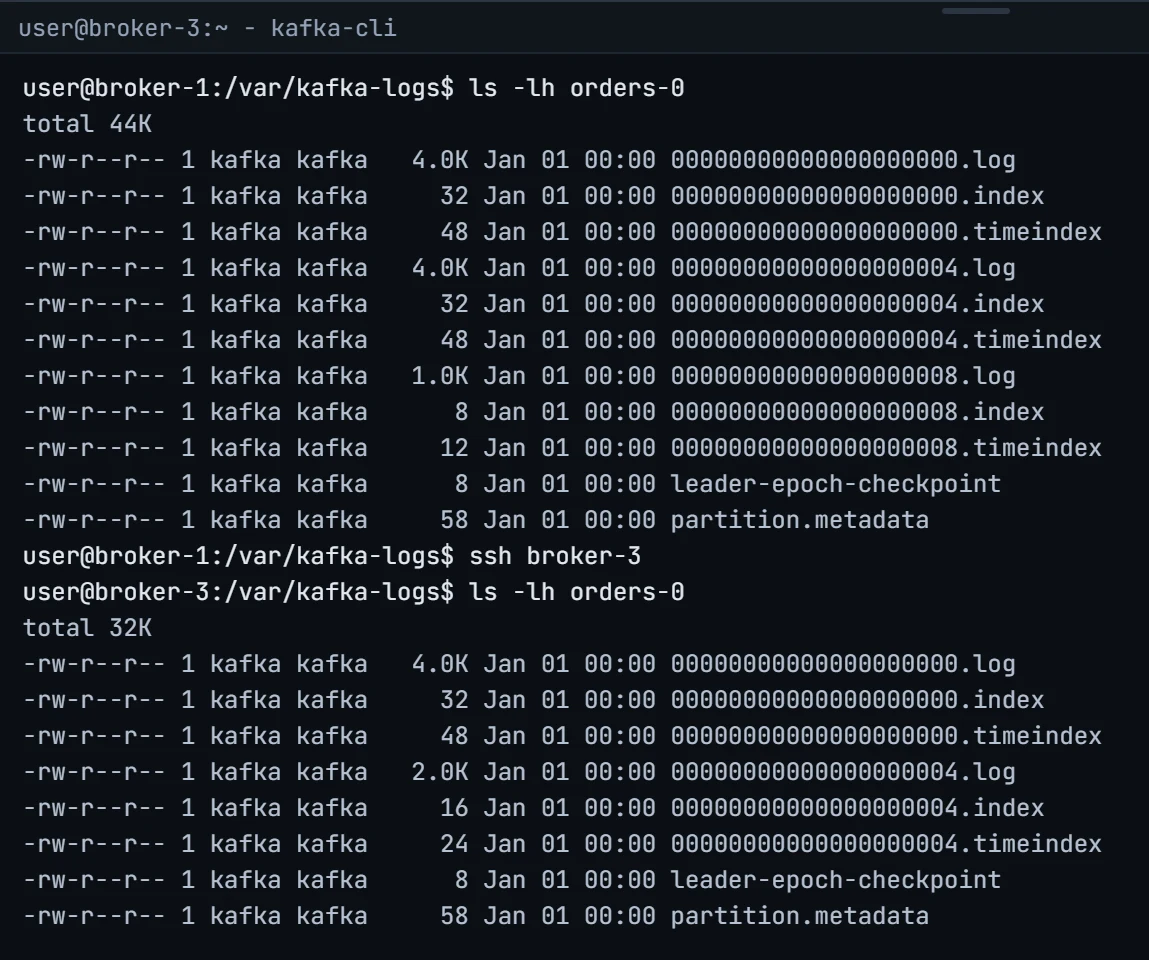
模拟的 Kafka 日志还有一个文件系统视图。 ls、cd、tree、du、df、cat 和 kafka-dump-log 操作的,正是模拟器为每个 broker 实际维护的那些日志段。
日志段的文件名使用 base offset,保留策略删除的是整个段文件,而如果某个 follower 被限流,你能看到它的活跃段落后于 leader 的活跃段。
CLI 的读取反映的是模拟器中当前可见的那一帧。如果你暂停模拟,或者在时间线上往回拖动,运行 --describe 查看的就是那个时间点。
CLI 的变更操作与模拟器中的其他任何操作一样:它们会被加入动作日志,可以通过 URL 分享,也可以逐帧重放。
这里的目标是学习迁移。
在真实事故中,关键在于你能不能看一眼 kafka-consumer-groups --describe,就立刻知道哪一列告诉你需要的信息。一个只给你按钮的模拟器可以展示概念,却没法真正教会那套工作流程。
为什么灾备来得这么晚
灾难恢复几乎把前面介绍过的一切都串联了起来:复制、消费者 offset、控制器仲裁组、保留策略以及故障处理。
当这些部分你都已经熟悉之后,它才更容易理解,这也是灾备模块在课程体系中出现得这么晚的原因。
v1.9 会在同一领域继续推进,带来 observer 和 Cluster Linking。
打开模拟器,对一个数据中心执行故障切换,然后打开终端,亲自查看滞后。